
Mengapa Pesanan Katering Sering Terlambat? Analisis Pengiriman dengan pandas
 Irfan Akbar Wildani27 September 20263 menit baca
Dari kelas Analisis Data dengan Python
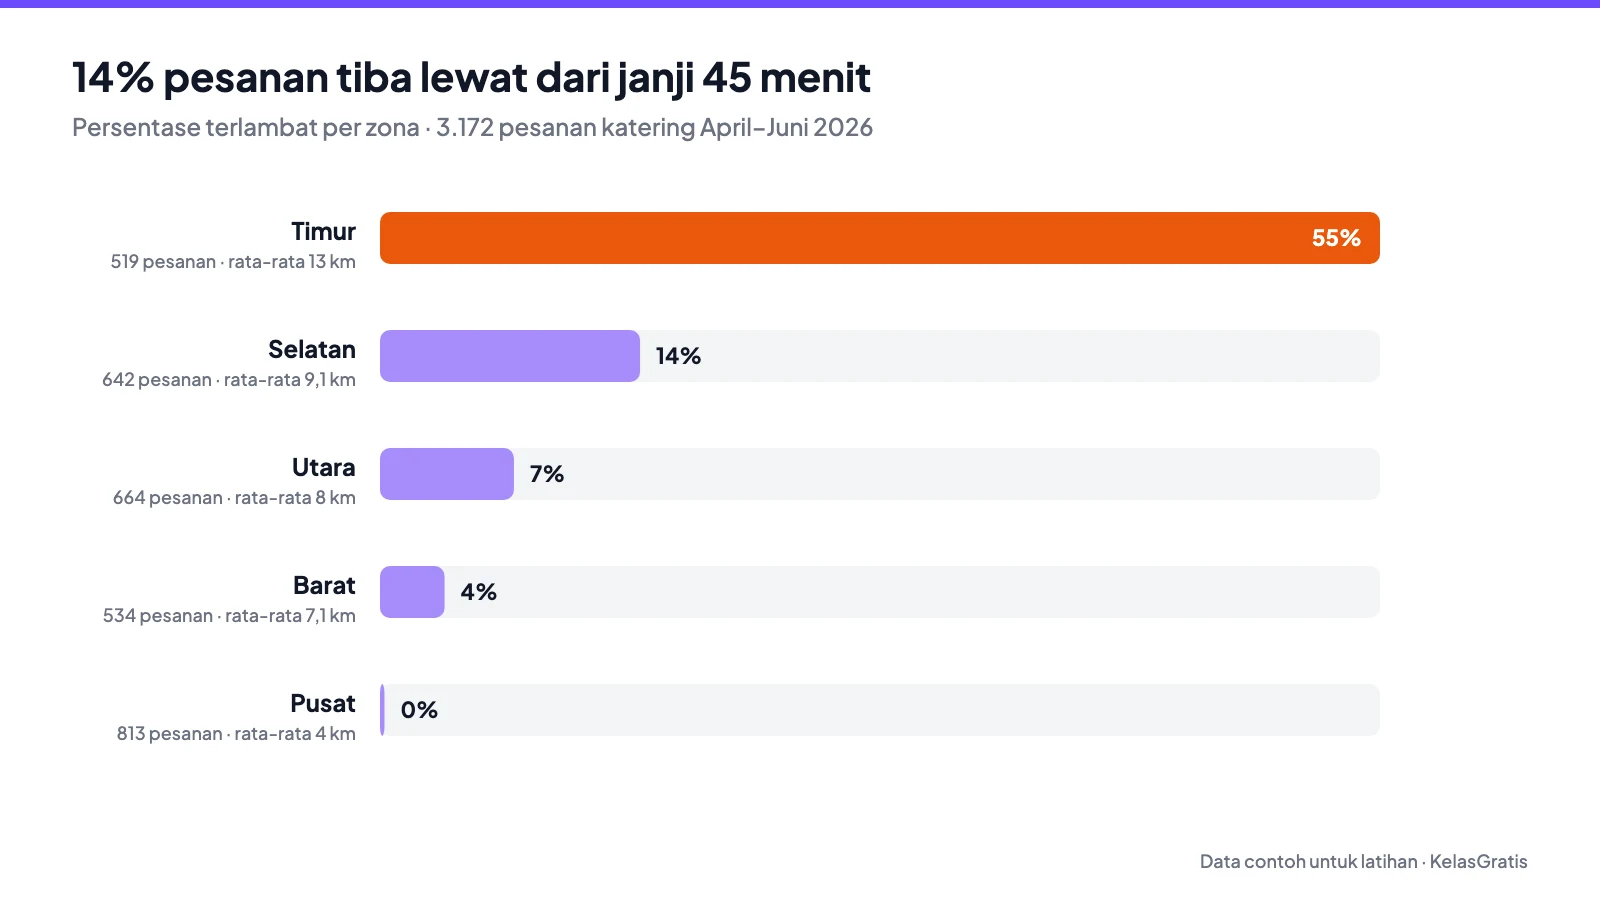
Menelusuri 3.200 pesanan contoh dengan pandas: membersihkan nilai kosong, merge data kurir, lalu groupby per zona dan jam. Keterlambatan bukan salah kurir, tetapi rute jauh yang berangkat di jam macet; menggeser jadwal zona Timur diperkirakan menurunkan keterlambatan dari 14% ke 11%.
Latar belakang
Usaha katering rumahan menjanjikan makan siang tiba paling lama 45 menit setelah kurir berangkat. Keluhan keterlambatan makin sering, dan pemilik menduga kurirnya yang lambat. Saya ingin memeriksa dugaan itu dengan data.
Pertanyaan:
- Seberapa sering pesanan terlambat?
- Apakah keterlambatan menumpuk di zona, jam, atau kurir tertentu?
- Perubahan apa yang paling murah dan paling berdampak?
Data
Data contoh yang saya bangkitkan untuk latihan, meniru pola pengiriman makan siang: 3.200 pesanan April–Juni 2026 dalam dua tabel CSV, pesanan.csv dan kurir.csv.
- 97 pesanan tanpa
jarak_kmdan 28 tanpawaktu_tiba - 5 zona, 6 kurir, jam berangkat 09.00–14.00
Alat
Python dengan pandas dan numpy, memakai teknik dari kelas Analisis Data dengan Python: read_csv, merge, penanganan nilai kosong, kolom tanggal, groupby, dan agg.
Proses
1. Memuat dan memeriksa data
import pandas as pd

pesanan = pd.read_csv("pesanan.csv", parse_dates=["tanggal", "waktu_berangkat", "waktu_tiba"])
kurir = pd.read_csv("kurir.csv")
pesanan.info()
pesanan.isna().sum()
2. Menangani nilai kosong
Jarak kosong diisi median zonanya, bukan median keseluruhan, karena zona Timur jauh lebih jauh daripada Pusat. Pesanan tanpa waktu tiba dibuang karena durasinya tidak bisa dihitung.
pesanan["jarak_km"] = pesanan["jarak_km"].fillna(
    pesanan.groupby("zona")["jarak_km"].transform("median")
)
pesanan = pesanan.dropna(subset=["waktu_tiba"])
3. Menggabungkan data kurir dan menghitung durasi
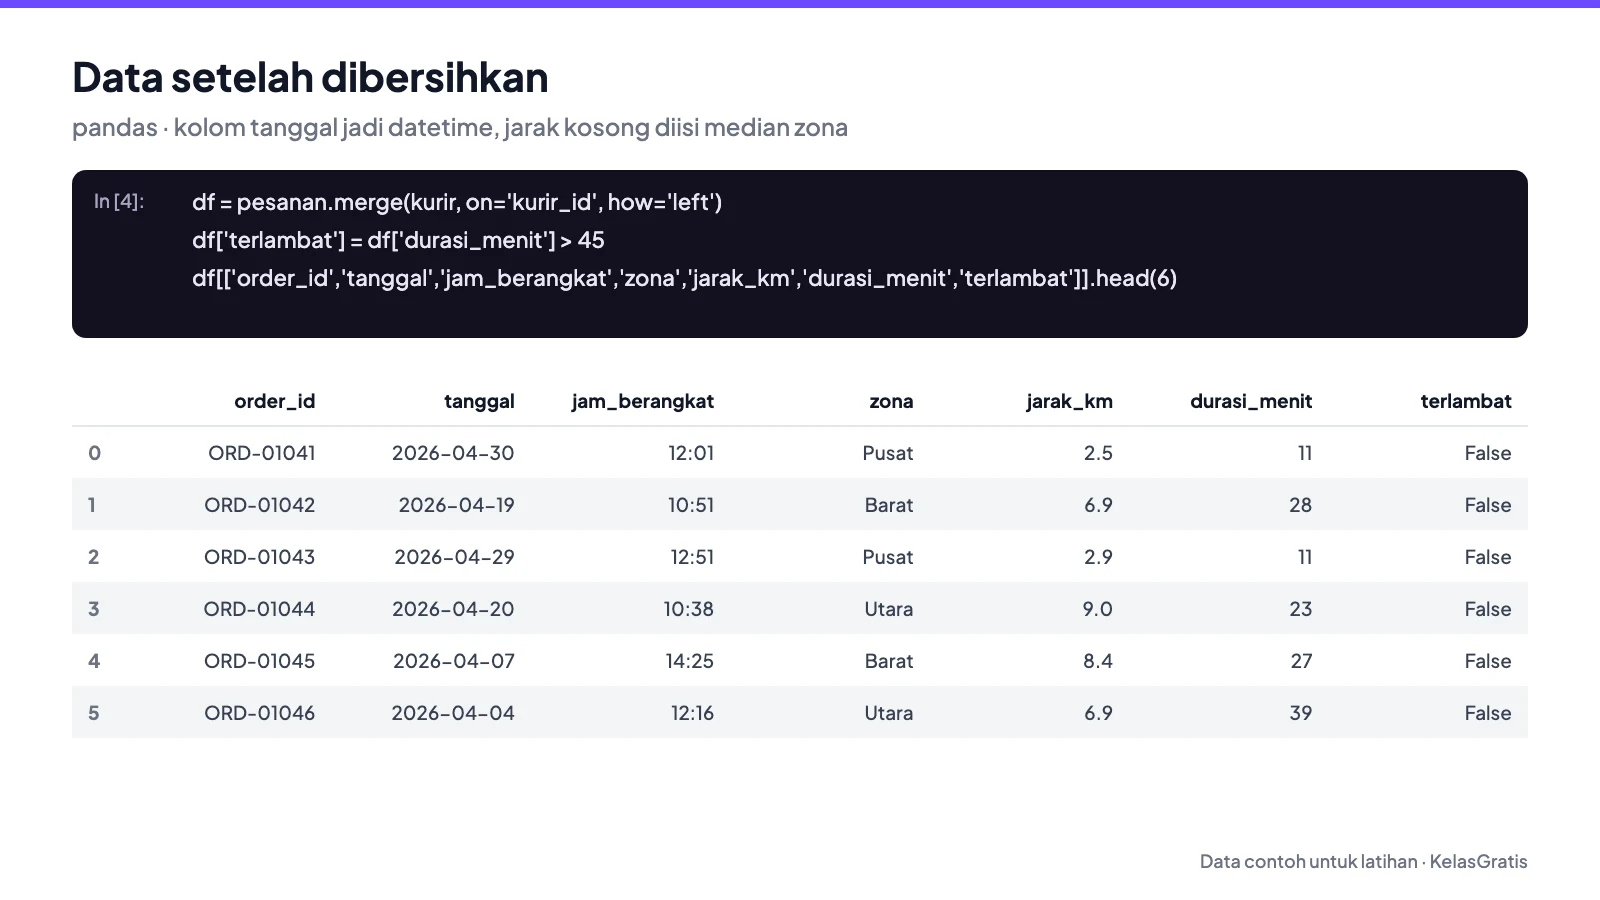
df = pesanan.merge(kurir, on="kurir_id", how="left")
df["durasi_menit"] = (df["waktu_tiba"] - df["waktu_berangkat"]).dt.total_seconds() / 60
df["jam_berangkat"] = df["waktu_berangkat"].dt.hour
df["terlambat"] = df["durasi_menit"] > 45
4. Mencari pola dengan groupby
per_zona = (
    df.groupby("zona")
      .agg(pesanan=("order_id", "count"),
           jarak_rata=("jarak_km", "mean"),
           persen_terlambat=("terlambat", "mean"))
      .sort_values("persen_terlambat", ascending=False)
)
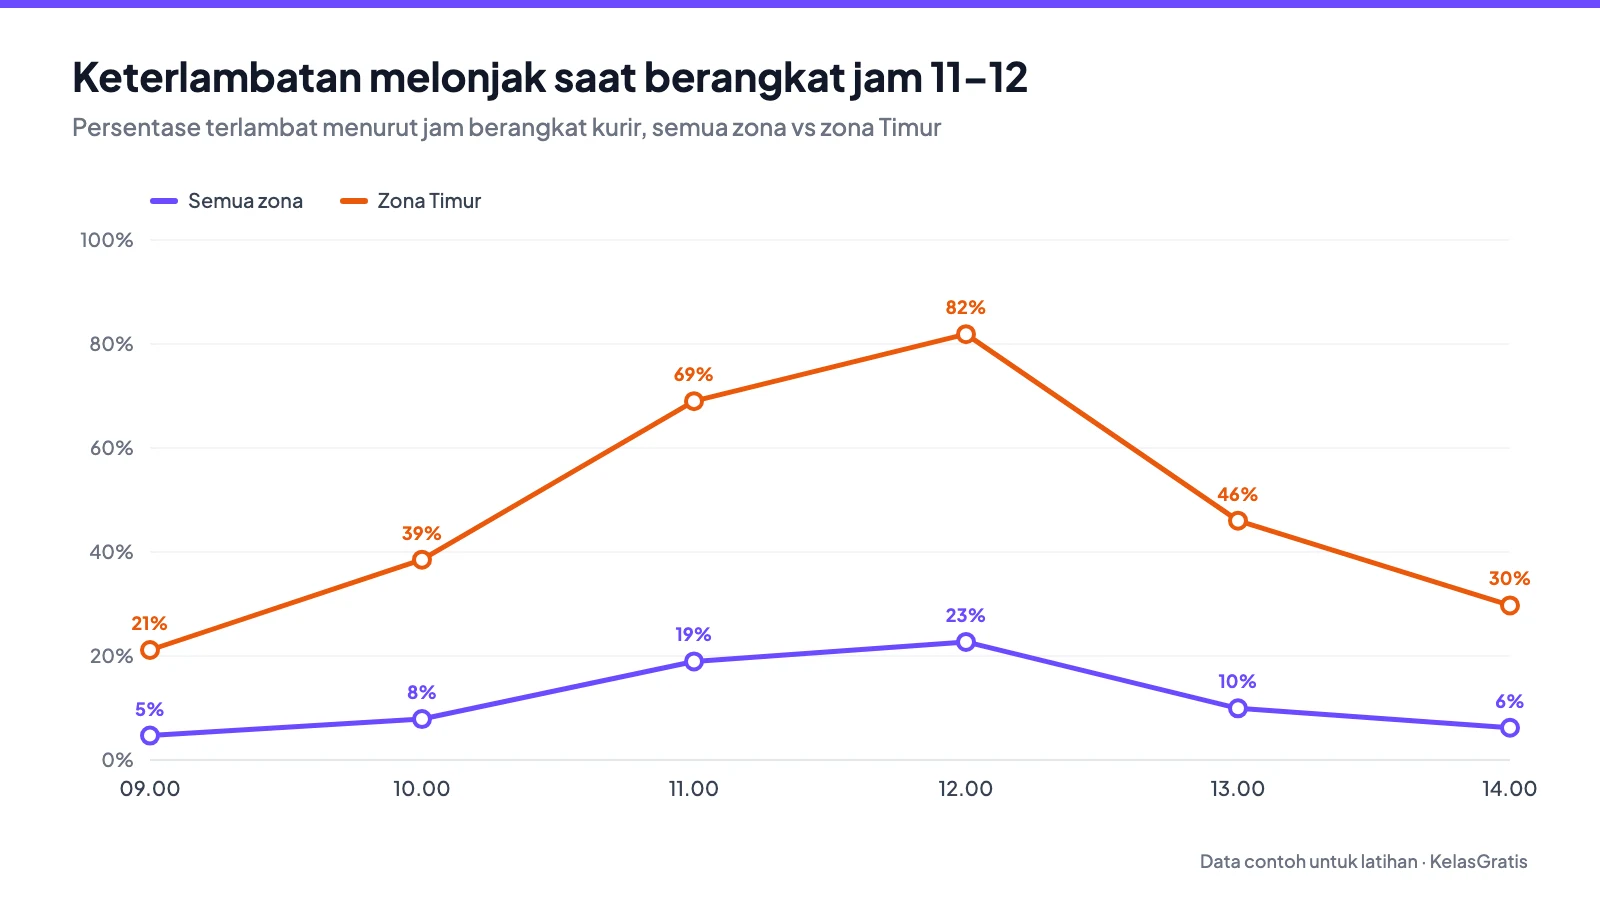
per_jam = df.groupby("jam_berangkat")["terlambat"].mean()
per_kurir = df.groupby("nama_kurir")["terlambat"].mean()
5. Menguji dugaan "kurirnya lambat"
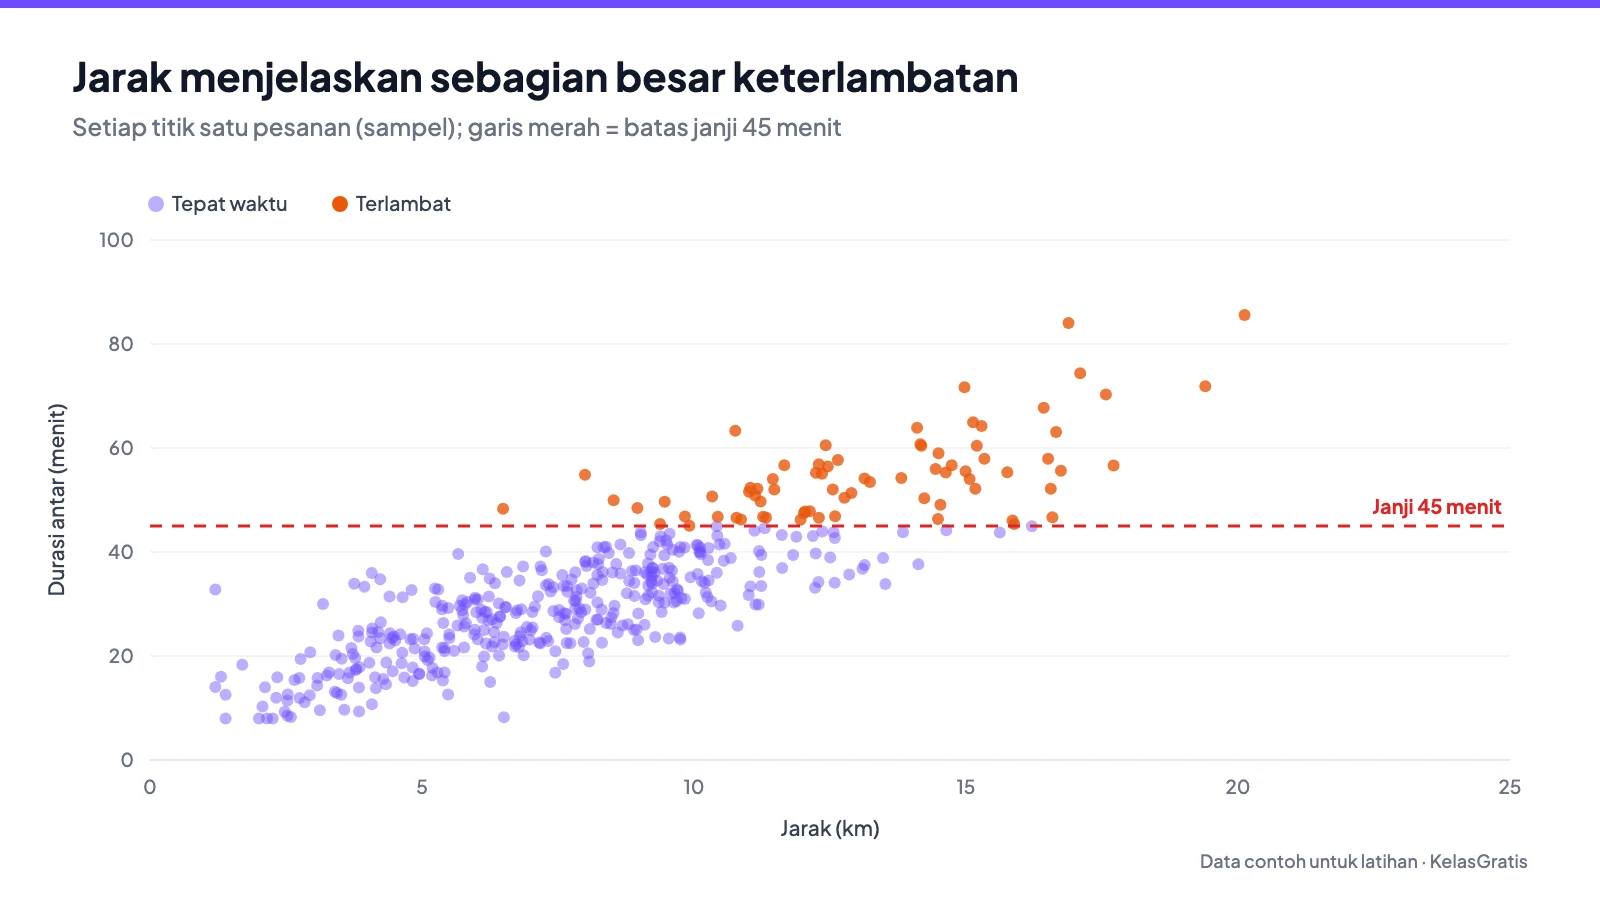
Tingkat keterlambatan keenam kurir hanya berkisar 12%–15%, jauh lebih sempit daripada selisih antarzona (0%–55%). Pola terbesar datang dari jarak dan jam berangkat:
Hasil
- Secara keseluruhan 14% pesanan tiba lewat dari 45 menit, rata-rata terlambat 9 menit.
- Zona Timur paling parah: 55% terlambat, dengan rata-rata jarak 13 km.
- Keberangkatan jam 11.00–12.00 paling bermasalah. Untuk zona Timur di jam itu, 75% pesanan terlambat.
- Dugaan awal soal kurir tidak didukung data. Masalahnya ada di rute jauh yang berangkat di jam macet.
| Zona | Pesanan | Jarak rata-rata | Terlambat |
|---|---|---|---|
| Timur | 519 | 13 km | 55% |
| Selatan | 642 | 9,1 km | 14% |
| Utara | 664 | 8 km | 7% |
| Barat | 534 | 7,1 km | 4% |
| Pusat | 813 | 4 km | 0% |
Rekomendasi
- Berangkatkan pesanan zona Timur pukul 10.00, bukan 11.00–12.00. Dengan pola data ini, 258 pesanan Timur di jam sibuk akan menghindari kemacetan. Perkiraan kasar: tingkat keterlambatan keseluruhan turun dari 14% menjadi 11%. Makanannya dimasak lebih awal dan dikemas dengan wadah penahan panas.
- Ubah janji untuk zona Timur menjadi 60 menit. Janji yang realistis lebih baik daripada janji yang sering dilanggar.
- Catat waktu tiba untuk setiap pesanan. 28 pesanan terbuang dari analisis karena kolom ini kosong.
Keterbatasan
Perkiraan pada rekomendasi pertama memakai pola rata-rata data ini, bukan uji coba nyata. Cara yang benar adalah mencoba jadwal baru selama dua minggu lalu membandingkan angkanya.
Yang saya pelajari
Mengisi nilai kosong dengan median per kelompok (groupby + transform) jauh lebih masuk akal daripada satu median untuk semua, dan groupby sering langsung membantah dugaan awal.
Irfan Akbar Wildani
Pengelola KelasGratis · Excel, SQL, dan Python untuk kerja
Proyek lain dari Irfan
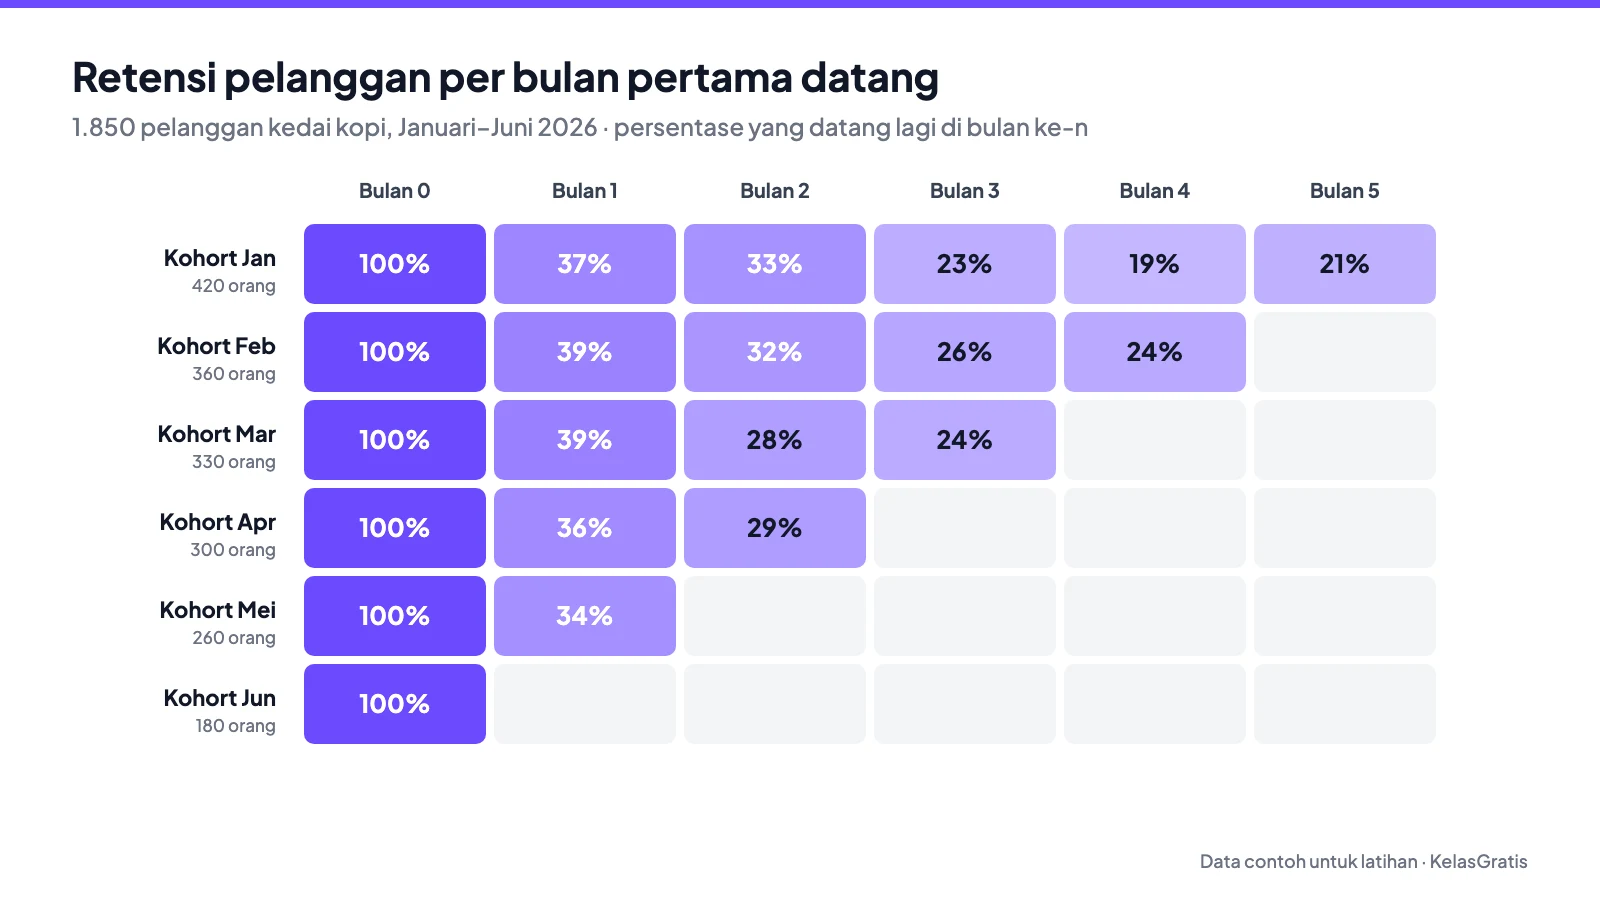
Siapa yang Kembali? Analisis Retensi Pelanggan Kedai Kopi dengan SQL
Tabel retensi kohort, segmen pelanggan, dan pola kunjungan pertama dari 1.850 pelanggan contoh dengan WITH, CASE, dan strftime di SQLite. Pelanggan setia hanya 11% orang tetapi menopang 33% omzet.
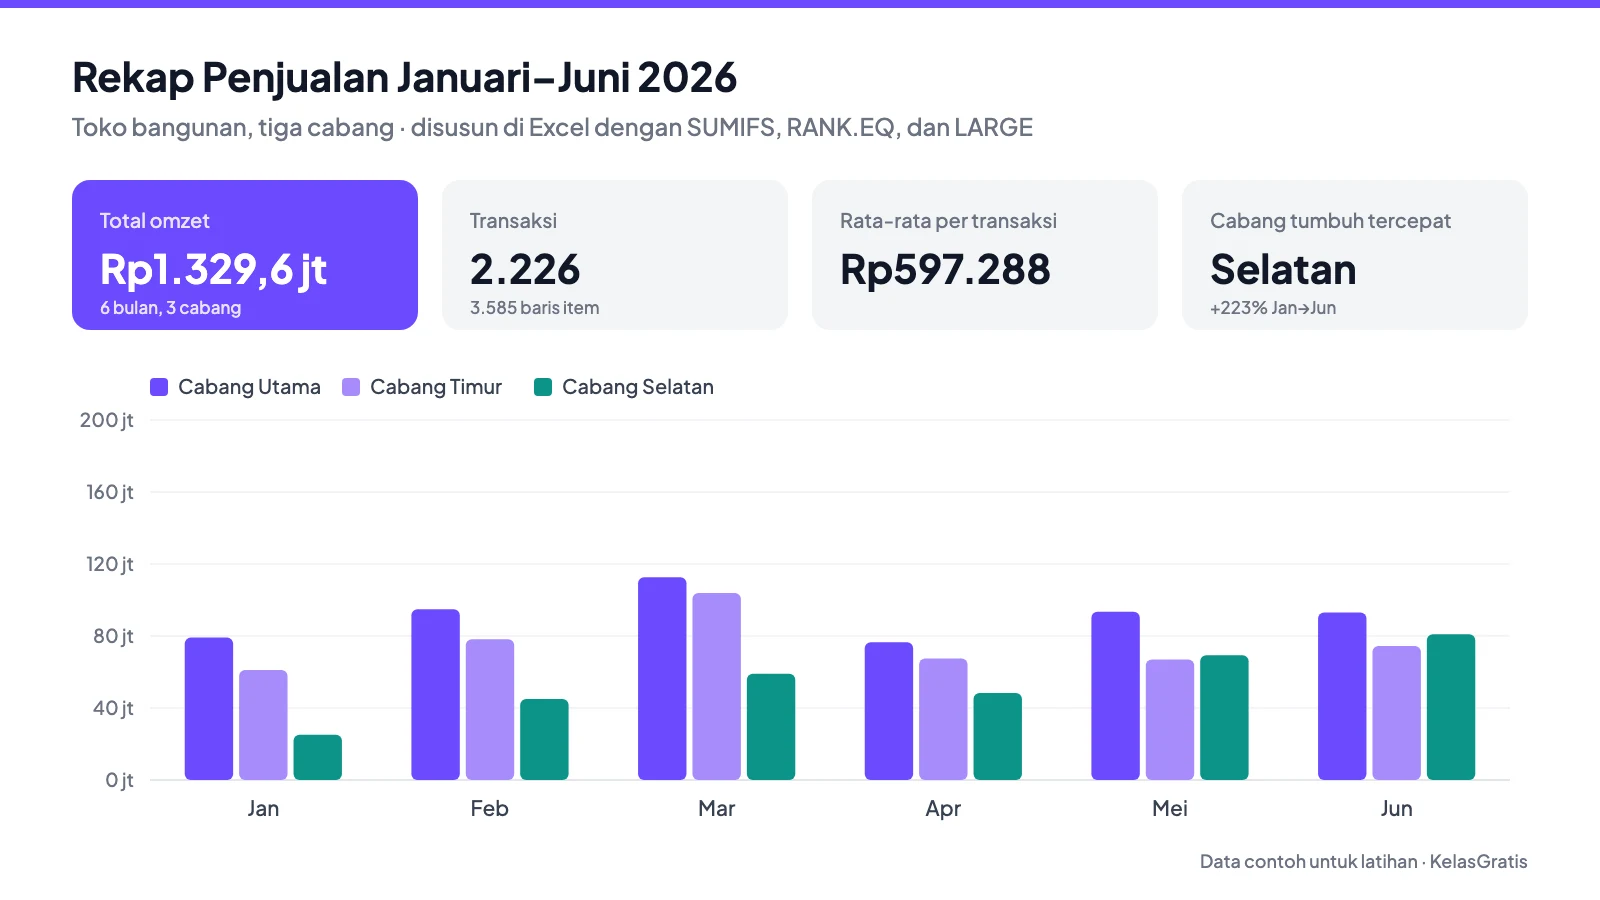
Rekap Penjualan 6 Bulan Toko Bangunan Tiga Cabang di Excel
Rekap bulan × cabang, peringkat cabang, dan lima produk teratas dari 2.226 transaksi contoh, disusun dengan SUMIFS, SUMPRODUCT, RANK.EQ, dan LARGE. Hasilnya: cabang Selatan tumbuh 223% dan lima produk menopang 72% omzet.